Hora Kit が機能を並列に走らせない理由
「Hora Kit の設計」シリーズの 7 本目。Hora Kit の遅さの主因は、機能を並列に走らせないことです。エージェントを複数並べて同時に走らせる話が流行っている中で、なぜ「機能は直列、単位は並列」にしているのか。並列化を阻んでいる git まわりの未解決の問題を書きます。
1. はじめに
この記事は、弊社(Open Reach Tech)が OSS にした AI 開発フレームワーク『Hora Kit』の設計を解説するシリーズの 7 本目です。メイン記事はこちらです。
本当の意味での自動開発を実現するためのAI開発フレームワーク『Hora Kit』をOSSにしました
用語の確認。 Hora Kit で打つコマンドは
/horaの 1 つだけです。/horaが状況に応じて/hora-spec(仕様書を書く)、/hora-setup(実装リポジトリを作る)、/hora-plan(版を確定し、機能一覧と契約を書く)、/hora-build(1 機能を 18 の関所に通す)、/hora-accept(検収する)を順に呼びます。/hora-hotfixだけは/horaが呼ばず、人が直接打ちます。docs はこのうち/hora-specを「決める側」、残りを「作る側」と呼んでいて、この記事でもその呼び方を使います。
メイン記事で「Hora Kit は遅い」と正直に書きました。遅さの主因は、機能を並列に走らせないことです。
エージェントを複数並べて同時に走らせる話が流行っているので、「なぜ並列にしないのか」はよく聞かれます。docs にはこの問いに答える「なぜ直列なのか」という節があって、その冒頭にこう書いてあります。「なぜ直列なのか」が残っていない設計は、次に触る人にとってはただの手抜きに見える、と。弊社がこの節を docs に残した理由もそれで、書いておかないと、いずれ誰かが並列実行を実装して同じ問題にぶつかります。
この記事では、その問題が何なのかを書きます。
2. 直列なのは機能と関所。単位は並列
先に正確に書いておきます。Hora Kit で並列に走らないのは「2 つの機能」と「2 つの関所」です。ただし 1 つの関所の内側では、その単位が並行します。テーブルごと、モジュールごと、操作ごと、コンポーネントごと、画面ごとに 1 体のエージェントが動きます。
「機能は直列、単位は並列」。この 2 つの主張の間にある距離が、この記事の主題です。
3. 問題は git であって、スループットではない
並列化を阻んでいるのは、性能の話ではなく git です。
Hora Kit では、実装エージェントは git に触れません。その成果は未コミットのまま作業ツリーに着地します。ここで 2 つのタスクを同時に走らせると、両方の成果が同じ作業ツリーに混ざります。後からタスクごとの綺麗なコミットに切り分けようとすると、次の問題にぶつかります。
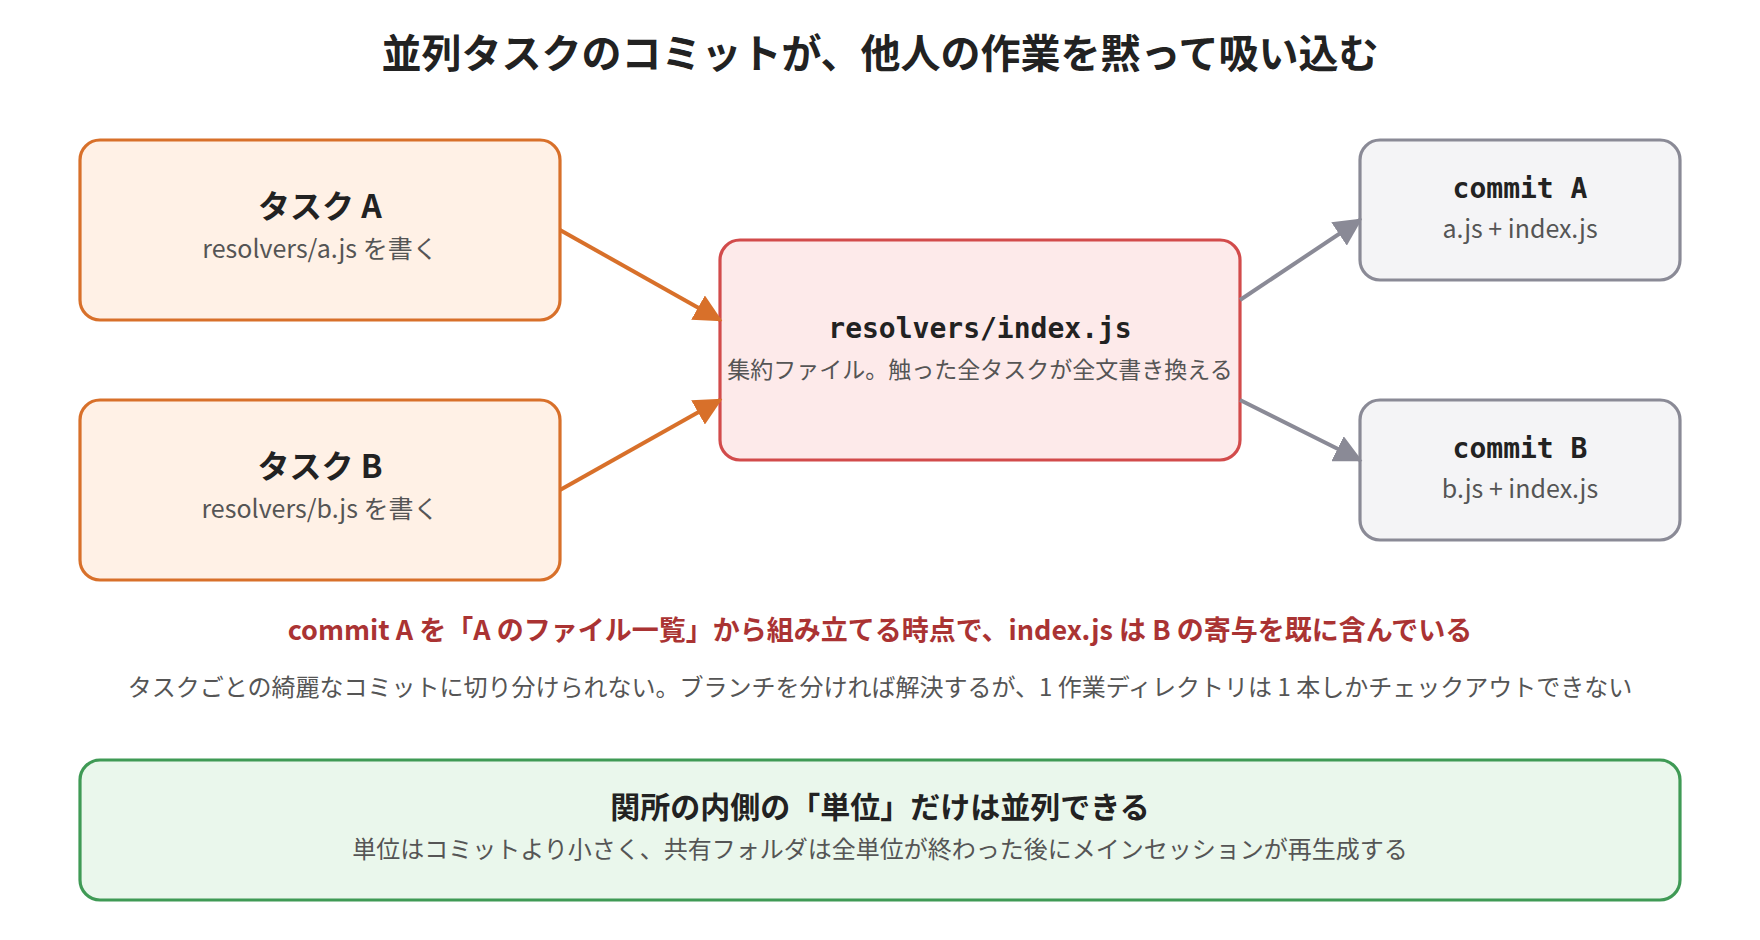
たとえば resolvers/index.js のような集約ファイルを想像してください。タスク A とタスク B が同時に走り、どちらも index.js を全文書き換えます。commit A を「A が触ったファイル」から組み立てると、index.js には B の分も入っています。docs の言い方だと、コミットは自分のものでない作業を黙って吸い込みます。
吸い込むこと自体が問題なのではなく、「黙って」吸い込むのが問題です。誰も気づかないまま、コミットの意味が壊れます。
4. ブランチを分ければ解決する。ただし
「タスクごとにブランチを切ればいい」と思った方は正しくて、それで解決します。ただし、1 つの作業ディレクトリは同時に 1 本しかチェックアウトできません。そして Hora Kit は git worktree を使っていません。
同じ制約は実行中にも出てきます。依存が途中で見つかったとき、直列ならそのタスクだけ止めて依存を導入し、rebase すれば済みます。並列だと、開いている複数のブランチがそれぞれ rebase を要求し、それは編集中の何かの足元で作業ディレクトリごと切り替えることを意味します。
docs はこう結論しています。これが本当に解決されるまで、直列は用心深い既定値ではなく、正しくコミットできる唯一の選択肢だ、と。
5. 並列の価値は、聞こえるほど大きくない
もう 1 つ、docs が指摘している点があります。Hora Kit の単位は小さなタスクではなく、製品全体への検収で終わる 1 機能です。1 機能が仕様 → バックエンド → フロントエンド → 検収と直列に進むので、機能同士を重ねられる余地はあまり残っていません。
並列化で縮むのは実装の部分だけで、検収は結局 1 本ずつ通すことになります。
6. 関所の内側だけが並列できる理由
関所の内側の単位は、上の問題の両側をどちらも回避します。だからこれだけが同時に走ります。
まず、単位はコミットより小さいものです。関所 6 のどの単位も、そのゲートのただ 1 つのコミットに着地するので、後続の単位の成果が吸い込まれる先の先行コミットが存在しません。次に、共有フォルダは全単位が終わった後にメインセッションが再生成するので、集約ファイルはどの単位も書きません。依存が必要になった場合は直列時の答えをそのまま使い、必要になった単位がそれを報告し、/hora-build が専用ブランチで導入してから作業が続きます。
7. 効くのはウォールクロックより、各エージェントが抱える量
単位を分ける理由は、速度だけではありません。
1 体で 6 つの resolver を書くエージェントは、6 つ分に伸びたコンテキストを抱え、以降の全ターンでその全量を支払います。6 体に分ければ、各自が 1 つ分だけを抱えます。docs には実測があって、build 中で最も重い単一エージェントは関所 6 のもので、最大の常駐コンテキストを抱えたまま 308 ターン回っていたそうです。
308 ターンにわたって全量を払うか、6 分割して各自 1 つ分を払うか。これはトークン量と精度の両方に効きます。
8. 弊社がこの遅さをどう受け入れたか
メイン記事の数字を再掲すると、10 万〜20 万行のシステムをリリースまで持っていくのに、Hora Kit で 2 週間、検証を飛ばしたフルバイブコーディングで最速 2〜3 日です。5 倍ほど遅く、この差の大部分が機能ごとの直列と、機能ごとの検収から来ています。
弊社がこれを受け入れた理由は、並列化で縮む時間より、間違ったテーブルの上に建てた機能を解きほぐす時間のほうが長いからです。docs の「層ごとではなく、機能ごと」の節にある表を引きます。
| 層ごと | 機能ごと | |
|---|---|---|
| 設計の不備が表に出る時点 | 最後のテスト段階 | その機能自身の検収 |
| その時点で上に積まれている量 | 全部 | ゼロ |
| 退行の見え方 | 20 の変更のどれかが壊した | 今入れた変更が壊した |
| コスト | 環境の立ち上げ 1 回 | 機能ごとに 1 回 |
コストは実在していて、承知の上で受け入れています。
9. まとめ
worktree を使えば、ブランチの制約は解けます。docs もそれを否定してはいなくて、「この設計は git worktree を使っていません」と現状を述べているだけです。機能の並列化に手を付ける人が上の問題を知らずに始めないように、理由を docs に残してあります。
「なぜ直列なのか」が書いてある設計は、並列化するときに何を解けばいいかも書いてある設計です。エージェントの並列実行を検討している方の参考になれば幸いです。
原典はこちらです。 https://github.com/openreachtech/hora-core/blob/main/docs/architecture.ja.md