本当の意味での自動開発を実現するためのAI開発フレームワーク『Hora Kit』をOSSにしました
弊社(Open Reach Tech)では最近、AI が書いたコードに対する人間のレビューを大幅に減らしています。社内のリードエンジニアや CTO が持っていたレビューの指針を Claude Code の skill に落とし込み、仕様書から 1 機能ずつ実装と検収を通してから次へ進む AI 開発フレームワーク『Hora Kit』を OSS として公開しました。なぜ人のレビューを減らせたのか、その代わりに何をしているのか、そしてそれにどれくらいのコストがかかっているのかを、実際の数字と一緒に紹介します。
1. はじめに
弊社(Open Reach Tech)では最近、AI が書いたコードに対する人間のレビューを大幅に減らしています。人が見ているのは仕様書と設計が中心で、コードそのものは要所を確認する程度に留め、あとは出来上がった画面を実際に触って UI/UX を確認してから本番に出す、という流れに変わってきました。
弊社はもともと、コードレビューを徹底する習慣を社内に根付かせてきた会社です。その会社が人のレビューを減らせるようになるまでには、それなりの経緯がありました。この 2 年ほど AI にコードとテストを書かせてきて分かったこと、そこで困ったこと、そしてその解決として社内のノウハウをまとめ上げたものの話です。
そのまとめ上げたものが、今回 OSS として公開する『Hora Kit』です。
https://github.com/openreachtech/hora-boilerplate
ひとことで言うと、社内のリードエンジニアや CTO が持っていたレビューの指針と開発の知見をすべて Claude Code の skill に落とし込み、仕様書を人と対話しながら書き、その仕様書をもとに 1 機能ずつ実装して検収まで通してから次の機能に進む、という進め方をオーケストレーションツールとして一般化したものです。「AI がコードを書いてくれる」ところで止まらず、「人がコードを細かく読まなくても本番に出せる」ところまで持っていくことを目標にしています。
本記事では、なぜ人のレビューを大幅に減らせたのか、その代わりに何をしているのか、そしてそれにどれくらいのコストがかかっているのかを、実際の数字と一緒に紹介します。Hora Kit の中身の細かい話は、別の記事に分けました(記事の後半でリンクします)。
先に断っておくと、Hora Kit は速くありません。一般的なバイブコーディングと比べると明らかに遅いですし、トークンもかなり使います。それでも弊社が使い続けている理由を、読みながら考えてみてもらえると嬉しいです。
2. 正しく情報を渡せば、AI は人より良いものを作る
Hora Kit を作る前の話から始めます。
弊社には 2 年ほど前から、「正しく情報を渡せば、AI は人間よりもはるかに良いアウトプットを出せる」という感覚がありました。実際に AI にコードとテストを書かせてみると、要件と設計と規約をきちんと渡した場合の出来は、人が書いたものより明らかに良かったからです。
問題は、その「正しく情報を渡す」の難易度がかなり高いことでした。何を作るのかを曖昧さなく言葉にし、設計の判断を先に済ませ、守るべき規約を漏れなく添える。これをある程度高いレベルでできる人は、弊社の感覚ではエンジニア全体の 1 割もいません。
1 年ほど前から AI にテストも書かせるようになって、この差はさらにはっきりしました。品質の高いテストとコードを AI に書かせられる人がいる一方で、テストに抜け漏れが多い人、可読性の低いコードをそのまま通してしまう人もいました。AI に渡す情報の質が、そのまま成果物に出ていました。
その差を埋めていたのが、人間のレビューです。弊社はもともとコードレビューを徹底する文化だったので、AI の出力もすべて人が見ていました。ただ、AI が書く量は人が書く量の何倍もあるので、レビューにかかる時間が膨らんでいきました。個人差が大きく、レビューに時間がかかる。これは弊社にとって新しい発見ではなく、最初から分かっていた問題でした。
そこで弊社が考えたのは、「正しく情報を渡す」という一番難しい部分を、人の技量に頼らずに済ませられないか、ということです。必要だと感じていたのは 2 つでした。1 つは、リードエンジニアや CTO レベルの人間が持っているレビューの指針と開発のノウハウを整理して、誰が AI を使っても同じ基準で作られるようにするワークフローです。もう 1 つは、AI のほうから人間を問い詰めて、仕様やユースケースを明確にしていく仕組みです。人が最初から完璧な仕様を書けないのなら、書けるように AI が質問すればいい、という発想です。
この 2 つを形にしたものが Hora Kit です。社内のノウハウを skill として書き出し、それを決まった順序で呼んで、確認が終わるまで次に進まないオーケストレーションにまとめました。
さらに、セキュリティのレビューもこのワークフローに組み込みました。セキュリティはプロジェクトの初期にはおざなりになりがちで、あとから慌てて見直すことが多い部分です。機能ごとに監査の関所を挟んでおけば、最初から高い水準でカバーできます。
実際に Hora Kit を通して開発を進めてみると、それまでのやり方では見つけられていなかった潜在的なバグと、セキュリティの脆弱性がいくつも見つかりました。人がレビューで見られるのは、結局その人が思いついたケースだけです。一方、機能ごとに仕様のユースケースをなぞりながら書かせ続けたテストと、決まった項目を毎回機械的に確認する監査は、人が思いつかなかったケースまで拾っていました。
AI の出力を担保するのは人の目ではなく、この網羅性である。人のレビューを大幅に減らす、という判断はここから始まっています。
3. Hora Kit がやっていること
使う側から見ると、打つコマンドは /hora の 1 つだけです。/hora はプロジェクトの現在地を判定して、次に必要な skill を順に呼びます。
/hora が呼ぶ skill | 役割 |
|---|---|
/hora-spec | 仕様書を書く。まだ仕様書が無いときに呼ばれ、7 つのステージで人と対話する |
/hora-setup | 仕様書が宣言した実装リポジトリを作り、プロジェクト固有の値を埋める |
/hora-plan | 作る版を確定し、仕様の穴を尋ね、機能一覧と契約を書く。毎回走る |
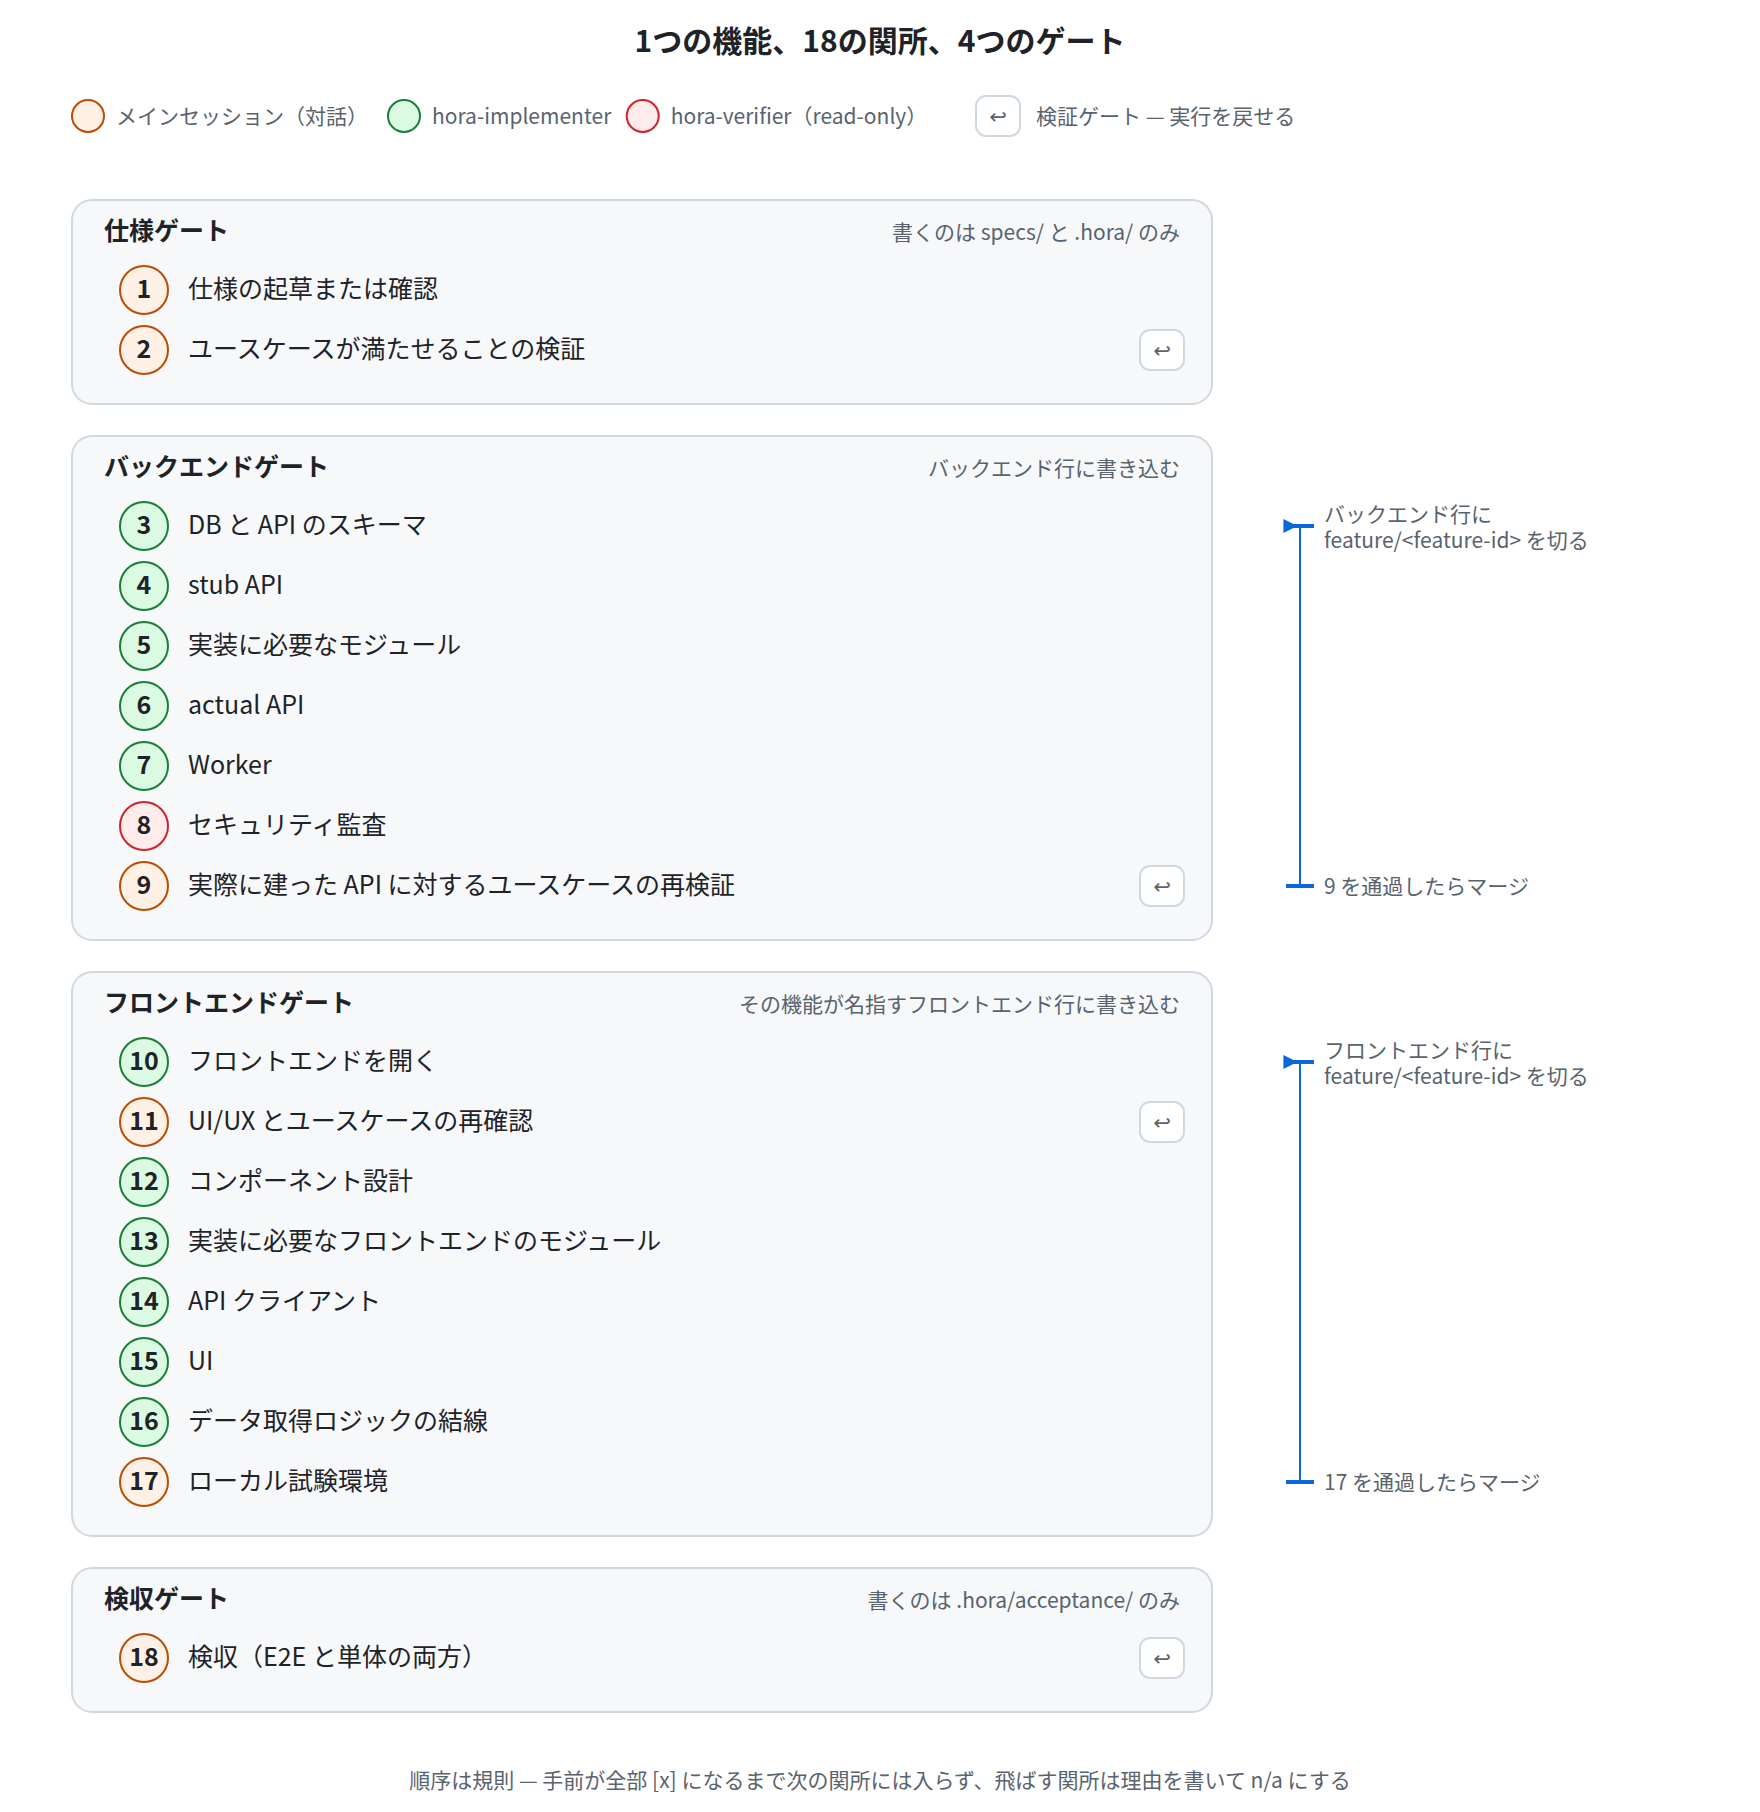
/hora-build | 1 つの機能を 18 の関所に通す。機能の数だけ繰り返す |
/hora-accept | 検収する。機能ごとの関所 18 と、版全体の掃引 |
この他に /hora-hotfix がありますが、これだけは /hora が呼ばず、緊急時に人が直接打ちます。
docs はこの 5 つのうち /hora-spec を「決める側」、残りの 4 つを「作る側」と呼び、Hora Kit を 2 つの部分として描いています。以下でもこの呼び方を使います。
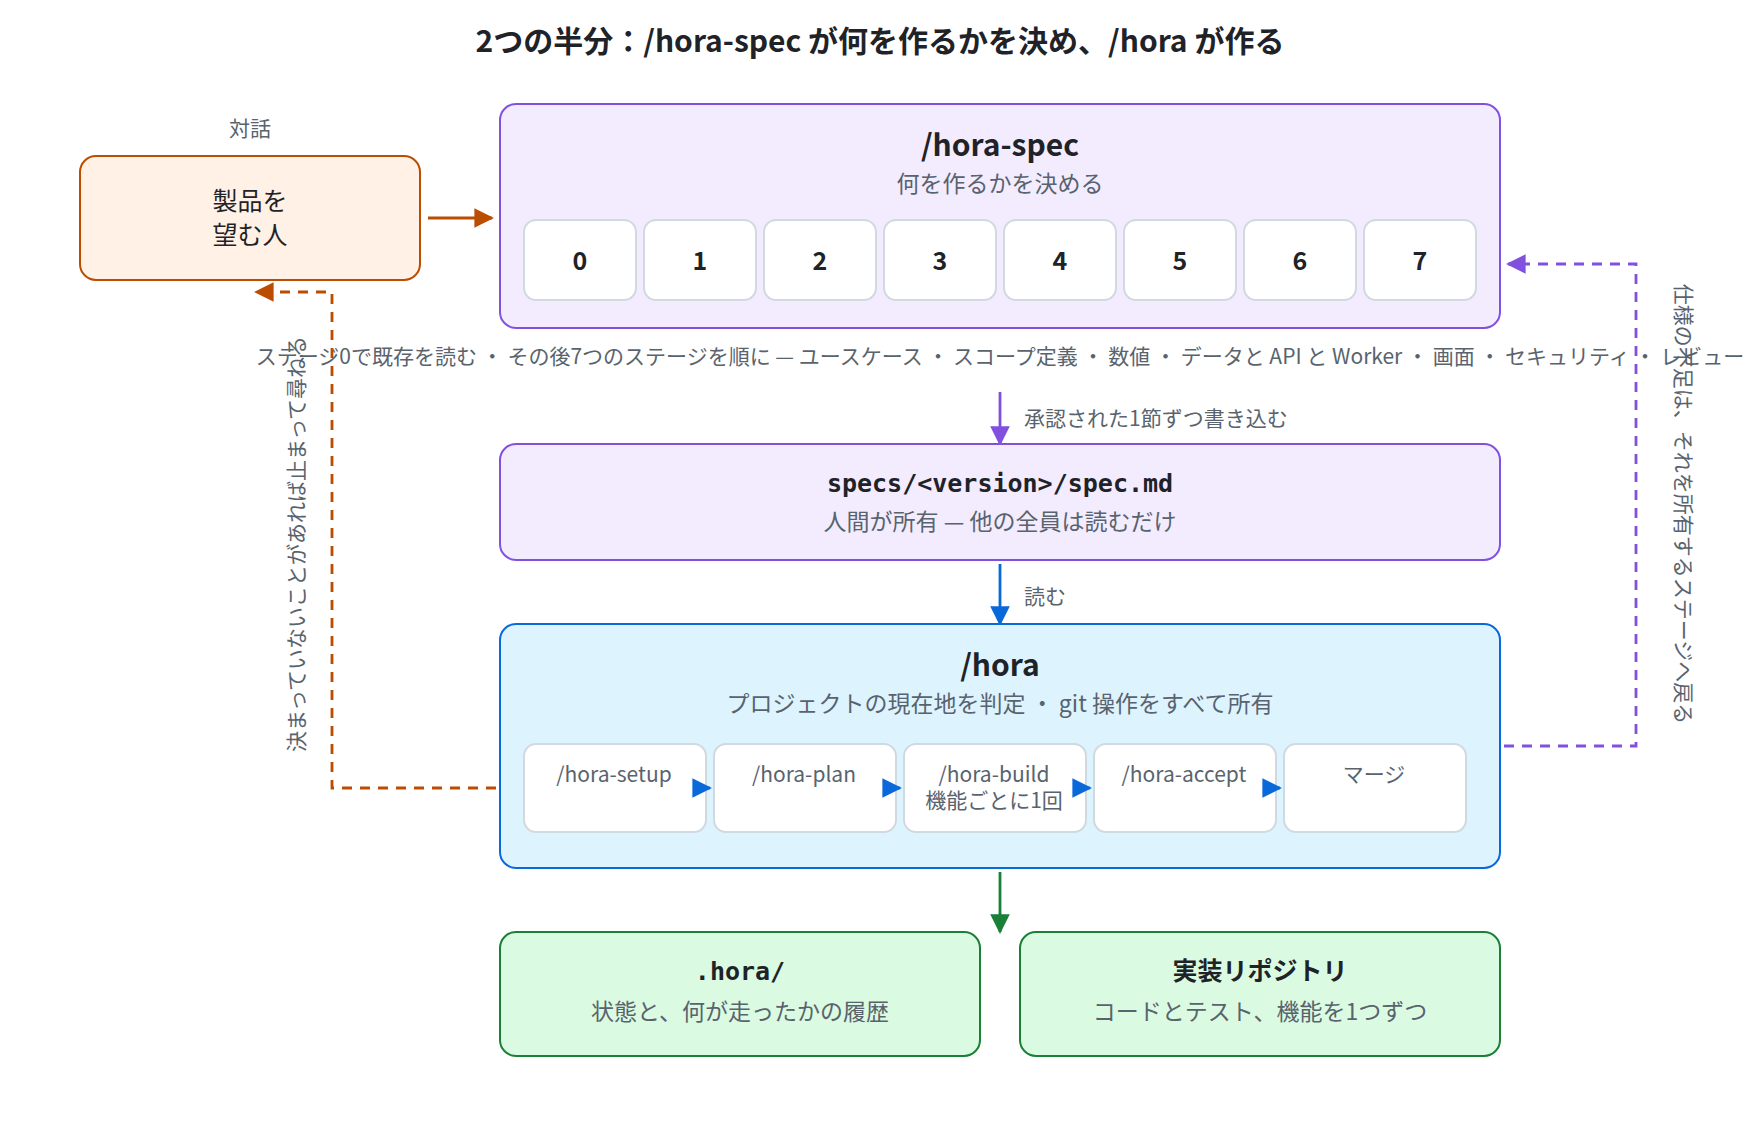
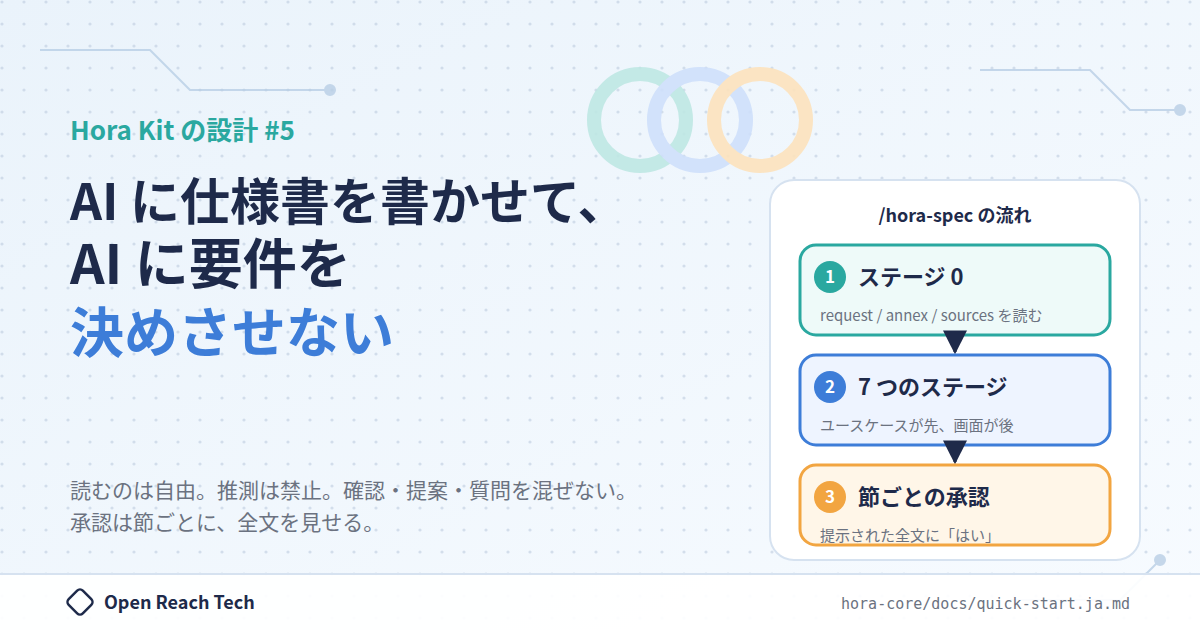
1 つは /hora-spec で、これは仕様書を書く側です。手元にある資料(メモ、モックアップ、古い設計書など何でも)を読み込み、質問と提案をしながら、仕様書を 1 節ずつ書いていきます。各節は全文が提示され、人が承認したものだけが書き込まれます。AI が勝手に要件を決めることはありません。
もう 1 つは作る側で、出来上がった仕様書をもとに /hora-setup、/hora-plan、/hora-build、/hora-accept が順に動きます。1 つの機能を 18 の関所(checkpoint)に通し、最後の検収を通ってから次の機能に進みます。途中で仕様に書かれていないことが必要になったら、推測で埋めずに止まって質問します。
2 つが共有しているのは specs/<version>/spec.md という仕様書のファイルだけです。
仕様書を書く側は、対話なので人が付き添う必要があります。一方で実装する側は、答えが必要なときには勝手に決めずに止まるので、走らせたまま放っておけます。弊社ではこの使い分けを「仕様は対話で、実装は自動執行で」と呼んでいます。
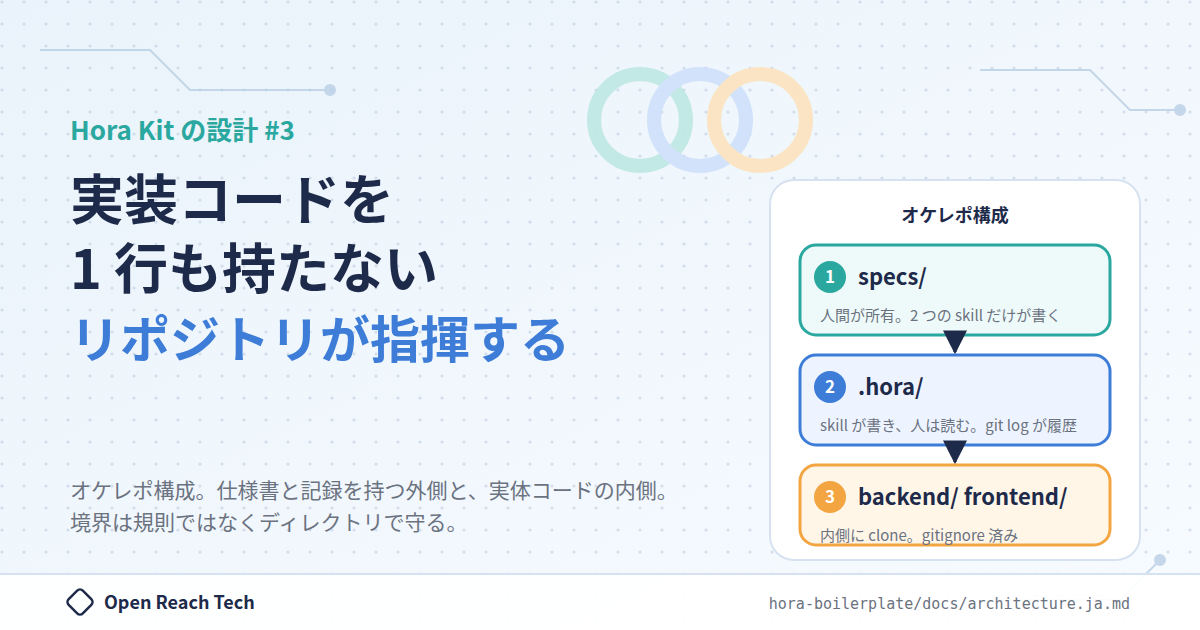
3.1 オケレポ構成: 指揮するリポジトリと、実体のリポジトリを分ける
もう 1 つ、Hora Kit の前提になっている管理手法があります。弊社では「オケレポ構成」と呼んでいます。
Hora Kit でプロジェクトを始めると、<myproject>-app というリポジトリができます。これがオーケストレーション用のリポジトリ(オケレポ)で、仕様書 specs/、実行の記録 .hora/、スタックの宣言 docs/stack/ を持ちます。一方で、アプリケーションの実体コードはこのリポジトリには 1 行もありません。実体は backend / frontend といった別の git リポジトリで、/hora がオケレポの内側に clone してきます。内側のリポジトリは gitignore されているので、オケレポを clone しても実体コードは付いてきません。
myproject-app/            ← オケレポ。仕様書・記録・スタック宣言だけを持つ
  specs/<version>/spec.md
  .hora/
  docs/stack/
  backend/                ← 実体。独立した git リポジトリ。gitignore 済み
  frontend-employee/      ← 実体。独立した git リポジトリ。gitignore 済み
こう分けておくと、「何を作ると決めたか」と「何が検収を通ったか」がオケレポだけで分かりますし、仕様と記録が実体コードと別の寿命を持ちます。実体のリポジトリを作り直しても仕様と記録は残りますし、逆に、仕様書を読める人に実体コードを渡す必要もありません。既存のプロジェクトに後から Hora Kit を被せるときも、既存リポジトリを外側から包むだけで済みます。
この構成の詳細は、シリーズの 3 本目に書きました。
4. なぜ人のレビューを大幅に減らせたのか
18 の関所を全部説明すると長くなるので、人のレビューを減らす決め手になった 3 つに絞って書きます。
4.1 同じユースケースを、違う段階で 3 回確認する
Hora Kit では、仕様書に書かれたユースケースを 3 回確認します。
1 回目は関所 2 で、仕様書の文面だけを見て「このユースケースは満たせるか」を確認します。2 回目は関所 9 で、バックエンドの API が出来上がった後に、実際の API を呼ぶ順番で同じユースケースをなぞります。3 回目は関所 11 で、今度は画面の設計に対して同じことをします。
ここで大事なのは、確認に失敗したときの動きです。たとえば 2 回目の確認で「この画面に必要なフィールドが API のレスポンスに無い」と分かったとします。普通なら、その場でフィールドを 1 つ足して先に進みたくなります。
Hora Kit ではそれをしません。関所 3(スキーマ設計)まで戻って、スキーマからやり直します。
なぜかというと、その時点でフロントエンド側は、すでに古い API の契約に対して作り始めているからです。バックエンド側だけでフィールドを足すと、契約と実装がずれます。ずれた契約はすぐには問題を起こさず、だいぶ後になってから「なぜかフロントとバックエンドで話が合わない」という形で表に出てきます。このずれは人が目視で追いかけるには限界がありますが、関所を戻す仕組みがあるので、追いかける必要そのものがなくなりました。
4.2 テストは毎回、全リポジトリで全部回す
関所 18 の検収では、ユニットテストを全リポジトリで毎回すべて実行します。対象の機能に関係するテストだけではありません。
これは単純ですが、効きます。ある機能の変更が以前の機能を壊したとき、壊したその実行で必ず落ちるからです。「いつの間にか壊れていて、何が原因か分からない」という状況が起きません。
そして、テストの量そのものも、人が書くのとは桁が違います。弊社では、テストの本数が 1 万本を超えるシステムを、スクラッチからすべて自動でコーディングし、本番投入まで持っていくことに成功しています。
人がこの本数のテストを書き続けるのは現実的ではありませんし、書けたとしても保守で腐っていきます。AI に書かせて、AI に毎回全部回させる。これが、動作の担保を人の目からテストに移せた一番大きな要因です。
4.3 セキュリティ監査を、読むだけで直さないエージェントが行う
関所 8 はセキュリティ監査です。バックエンドのコードを書いた機能では、この関所を飛ばすことはできません。
この監査には少し変わった特徴があって、監査を行うエージェントには、ファイルを編集する権限がありません。見つけた問題を報告するだけで、直しません。修正は別のエージェントが行い、そのあとで監査をもう一度実行します。
なぜわざわざ分けているかというと、同じエージェントに「書く」と「検める」を両方やらせると、落ちるテストを緩めて通してしまう、という抜け道が生まれるからです。AI エージェントはテストを通すことに向かって最適化するので、この道は放っておくと使われます。権限で塞いでおくのが確実でした。
見つかった指摘を「これは許容する」と判断するのも、AI ではなく人です。許容した指摘は質問として記録に残り、静かに合格扱いになることはありません。
セキュリティレビューは後回しにされがちな作業ですが、機能ごとにこの関所が挟まるので、まとめて後からやる必要がありません。
監査の対象はその機能の変更分と、その機能が新しく宣言した operation と endpoint です。リポジトリ全体を毎回見るわけではありません。ただし「既存のコードへ新しく繋いだ呼び出し元」は対象に含めています。変更したファイルだけを見ていると、認可の抜けはちょうどそこで漏れるためです。
5. 正直に言うと、遅いしトークンも食います
ここまで良い話ばかり書いてきたので、コストの話もしておきます。
Hora Kit は遅いです。機能ごとにコンテナ群を立ち上げ、検収を通し、それから次の機能に進むので、機能同士を並列に走らせていません。docs にも「なぜ直列なのか」という節があって、並列化が git まわりの未解決の問題に阻まれていることが書いてあります。
トークンも使います。18 の関所をそれぞれ別のエージェントが担当するので、1 機能あたりの会話量はどうしても多くなります。
弊社で実際に測った数字はこうです。
| Hora Kit | 検証を飛ばしたフルバイブコーディング | |
|---|---|---|
| 環境 | $110 のチームプラン(Premium) | 同じ |
| 10 万〜20 万行のシステムをリリースまで | 2 週間 | 最速 2〜3 日 |
| 成果物の品質・テスト網羅性・セキュリティ | 本番投入できる水準 | セキュリティ脆弱性、可読性の低いコード多数 |
速度で言うと 5 倍ほど遅くなります。それでも弊社では、本番運用を想定したリリースであれば、これは必要なコストだと考えています。
なお、この表の「品質」の行は、今のところ弊社が実際の成果物を見比べた定性的な評価です。循環依存や複雑度、テストのカバレッジといった定量的な指標を計測したレポートを、別途リリースする予定です。
そして、人と比べれば圧倒的に安いです。10 万〜20 万行のシステムを人がリリースまで持っていこうとしたら、どれだけ急いでも数か月はかかります。それが $110 のプランと 2 週間で済むわけです。
ただ、コストの差が本当に大きく出るのは、新規開発ではなく保守のほうでした。
6. 保守で助かっていること
6.1 仕様書が版ごとに残る
仕様書は specs/<version>/spec.md という形で、リリースの版ごとに置かれます。
2 つ目の版からは、仕様書には 1 つ前の版との差分だけを書きます。過去の版の仕様書には手を入れません。
specs/
  1.0.0/spec.md    最初の版。全文
  1.1.0/spec.md    1.0.0 に対する差分だけ
この形にしておくと、「1.0.0 のとき何を作ると決めたのか」が、1.1.0 を作った後でもそのまま読めます。人が書いた設計書は、更新されずに腐っていくか、最新の状態に上書きされて過去が消えるかのどちらかになりがちですが、その問題が構造として起きません。
git のブランチもこの版に対応していて、release/<version> から機能ブランチが切られ、関所のゲートごとにマージされます。緊急の修正だけは別の経路があり、main から hotfix/ を切って直接戻し、その後 /hora が開いているリリースラインを新しい main に追従させます。
6.2 .hora/ に記録が残り続ける
Hora Kit には、いわゆる状態ファイルがありません。状態は .hora/ というディレクトリそのもので、その中の Markdown のチェックボックスが状態になっています。
.hora/
  tasks/<version>/<feature-id>.md      1 機能と、その 18 の関所のチェックボックス
  acceptance/<version>/<feature-id>.md その機能の検収の全実行。1 実行 = 1 ブロック追記
  questions/<version>/open.md          追記のみ。答えるときは specs/ を編集する
  contracts/<version>/                 他リポジトリから使われるサーバーの契約
  glossary.md                          追記のみ
何が走ったかの履歴は git log .hora/ で追えます。docs には「他に記録している場所はなく、その必要もありません」と書いてあります。
これが保守で効いてきます。しばらく前に作った機能について「なぜこの判断になったのか」を知りたいとき、弊社のエンジニアは .hora/questions/ と .hora/acceptance/ を読みます。そのとき何が質問され、検収で何が指摘され、どこに戻されたかが全部残っているので、当時の会話ログを掘り返す必要がありません。
7. 100 万行のシステムでも動いています
Hora Kit は弊社のプロダクトと、一部の顧客プロジェクトで実際に使っています。大きいものだと、100 万行近いコード、300 のテーブル、数十億のレコードを持つシステムです。
このシステムは Hora Kit で最初から作ったものではなく、動いているコードの周りに後から Kit を被せたものです。それでも安定して開発が続けられています。
規模が大きくなるほど効いてくるのは、「機能ごとに検収まで通す」という順序です。層ごとに作る、つまりバックエンドを全部作ってからフロントエンドを全部作って最後にテストする、という順序だと、設計の不備が表に出るのは最後のテストのときで、その時点で上には全部が積み上がっています。機能ごとに検収まで通していれば、不備が出た時点で上に積まれているものはありません。
8. Hora Kit を構成する OSS
Hora Kit は 1 つのリポジトリではなく、役割ごとに分かれた OSS の集まりです。利用者が直接 clone するのは boilerplate だけで、残りは boilerplate の npm install が依存として引いてきて .claude/ に配置します。
| 役割 | リポジトリ | 利用者との関係 |
|---|---|---|
| 入口。プロジェクトのテンプレート | hora-boilerplate | これだけを直接使う。GitHub の Use this template で <myproject>-app を作る。仕様書 specs/、記録 .hora/、スタック宣言 docs/stack/ を持つ |
| 中枢。オーケストレーターとエージェント | hora-core(npm: @openreachtech/hora) | 直接は触らない。/hora、/hora-spec、/hora-plan、/hora-build、/hora-accept、/hora-hotfix と 3 つのエージェントを配布する。順序と関所だけを持ち、手順は持たない |
| 手順と合否基準。スキルライブラリ 4 つ | hora-skills-ort-core / -renchan / -furo / -support | 直接は触らない。core が「何をする作業か」を述べると、実行時にこれらのスキルが description でマッチされる。合計 119 スキル |
| モジュールカタログ | hora-ecosystem | 直接は触らない。弊社のパッケージ群(renchan-* / furo-* / mentsu-*)の使い方を AI が学ぶためのデータ |
| 実装リポジトリの雛形 | renchan-boilerplate(backend)/ furo-boilerplate-nuxt(frontend) | /hora-setup が <myproject>-app の内側に clone する。利用者が clone する必要はない |
| フレームワーク | renchan-core(npm: @openreachtech/renchan)/ furo-nuxt(npm: @openreachtech/furo-nuxt) | 実装リポジトリの依存として入る。renchan は Express ベースの GraphQL / REST バックエンド、furo-nuxt は Nuxt 向けのクライアントフレームワーク |
core とスキルパッケージを分けているのは、スキルパッケージのほうが core とは独立に更新されるためです。core 側に手順の写しを持たせると、パッケージが更新された瞬間にその写しが古くなり、しかも誰もそれに気づきません。そこで core は「何をする作業か」だけを述べ、実際の手順はパッケージに任せる形にしています。boilerplate は、その両方を依存として宣言して npm install で揃える役目です。
ここで 1 つ、はっきりさせておきたいことがあります。「弊社の技術に寄っている」のは、あくまで hora-boilerplate と 4 つのスキルパッケージの側です。hora-core のほうは、特定のフレームワークや DB の名前を一切持たず、一般的な Web 開発でそのまま使える構成にしてあります。順序と関所はスタックを知らない、という設計です。
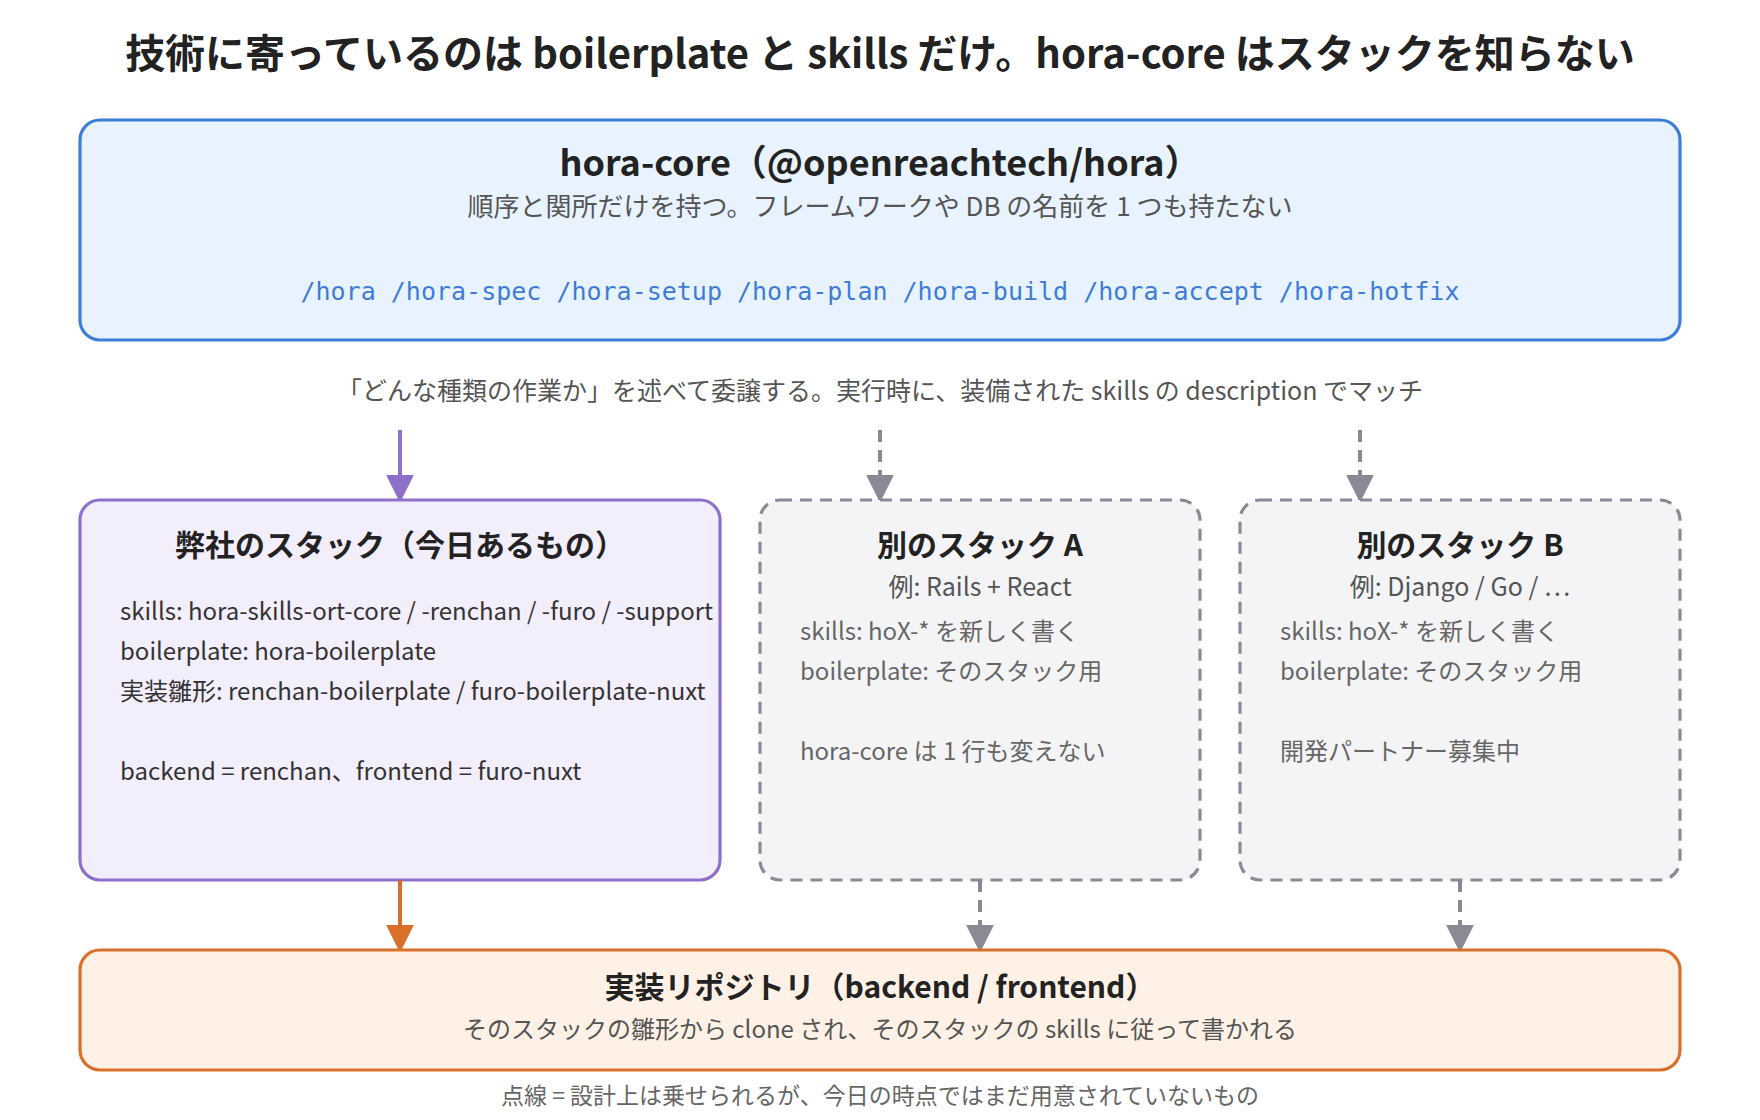
だから、別の技術スタック向けにスキル群を定義し、そのスタック用の boilerplate を用意すれば、Hora Kit はあらゆる技術スタックに転用できます。今日の時点で用意できているのは弊社のスタック(renchan / furo-nuxt)の分だけですが、これは設計上の制約ではなく、まだ誰も書いていないというだけです。
この「各技術スタックごとのスキル群を定義する」活動を、弊社と一緒に進めてくれる開発パートナーを募集しています。Rails でも Django でも Go でも、自分たちのスタックの規約とレビュー基準を skill に落とし込んで Hora Kit に乗せたい、という方がいれば、Issue かメイン記事のコメントで声をかけてください。
Hora Kit で書いた仕様書と、作ったアプリのサンプルは、現在整備中です。数十万行規模のものを公開する予定で、詳しくは「今後の予定」の節に書きました。
9. 使い方
仕様書を先に書いておく必要はありません。手元にあるものを置いて /hora を打てば、仕様書を書くところから始まります。
9.1 テンプレートからリポジトリを作る
https://github.com/openreachtech/hora-boilerplate で Use this template を選び、<myproject>-app という名前で作ります。
git clone <作ったリポジトリ> myproject-app
cd myproject-app
npm install   # postinstall が Hora Kit と 4 つのスキルパッケージを .claude/ に配置する
Node.js はアクティブ LTS を使ってください。Windows の場合は WSL 2 の中で動かす必要があります。
9.2 手元にあるものを入れる
specs/1.0.0/request/   このバージョンで作ってほしいこと(箇条書き 1 枚でもいい)
specs/1.0.0/annex/     それを説明する資料(モックアップ、ER 図、古い設計書、スプレッドシート)
specs/1.0.0/sources/   すでに内容が決まっている仕様(迷ったら annex/ へ)
整っている必要はありませんし、PDF や PNG でも構いません。
9.3 Claude Code で /hora を実行する
/hora
まだ仕様書が無いので、/hora は /hora-spec を呼びます。置いたものを読んで、質問と提案を返してくるので、承認した節から順に spec.md に書かれていきます。
仕様書が書き上がったら、あとは /hora を打つだけです。セットアップ、計画、実装、検収まで進み、答えが必要なところで止まります。
10. もっと詳しく
本記事では省いた仕組みの細部を、「Hora Kit の設計」シリーズとして別の記事にしています。
- Hora Kit は 1 つの文書を共有する 2 台の機械です(全体像。最初に読む地図)
- Hora Kit が手順を 1 つも持たない理由(Core と Skill の分離、スタック非依存)
- 実装コードを 1 行も持たないリポジトリが全体を指揮する(リポジトリ構成と git モデル)
- 1 つの機能が通る 18 の関所と 4 つのゲート
- AI に仕様書を書かせて、AI に要件を決めさせない(/hora-spec の 7 ステージ)
- 状態ファイルを持たない再入可能オーケストレーター(.hora/ の設計)
- Hora Kit が機能を並列に走らせない理由
- 読むだけで直さない監査と、戻り先のある指摘(関所 8 と /hora-accept)
- 動いているコードの周りに Hora Kit を被せる(既存プロジェクトへの適用)
- 本番が壊れていて、使える時間は 2 時間(/hora-hotfix)
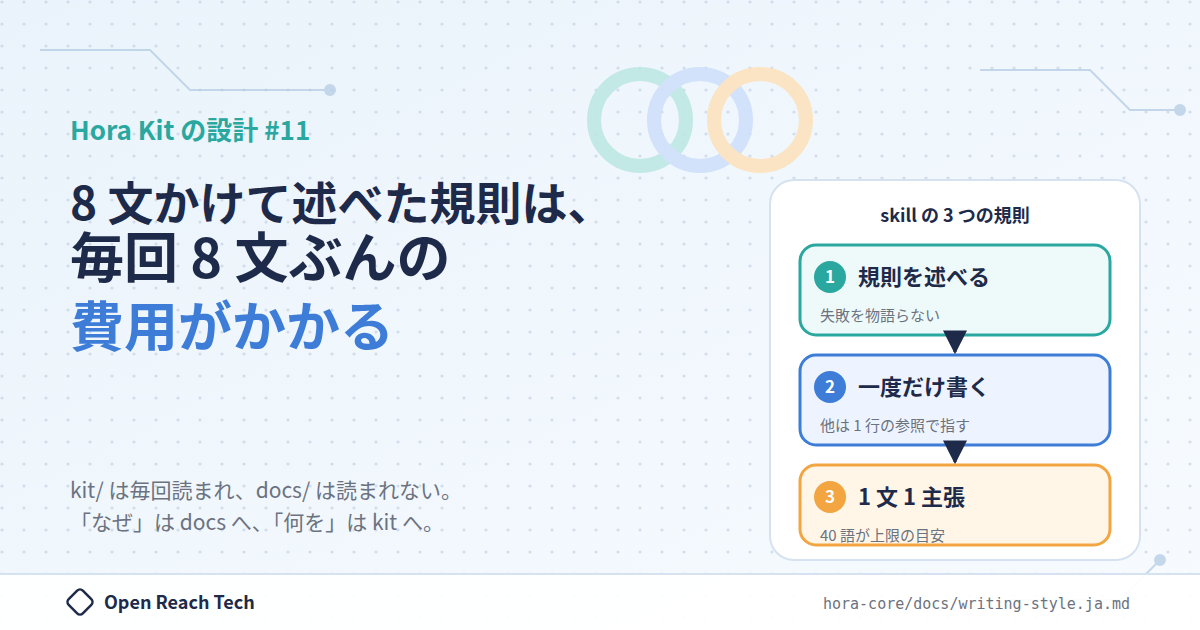
- 8 文かけて述べた規則は、毎回 8 文ぶんの費用がかかる(skill の書き方)
- 仕様書を版ごとの差分で持つ
全体の設計思想は hora-core の docs にまとまっています。長いですが、「なぜこの形なのか」が一通り書いてあります。 https://github.com/openreachtech/hora-core/blob/main/docs/architecture.ja.md
11. 今後の予定
Hora Kit はまだ発展途上で、次のような項目を予定しています。
- さらなる高速化と、トークン消費量の削減
- 弊社の renchan / furo といった独自技術スタック以外のフレームワークや言語のサポート。技術スタックごとの skills を拡張する形で進めます
- Codex や Cursor、Antigravity など、Claude Code 以外の AI エディタのサポート(今でも大部分はそのまま使えます)
- 具体的な実装パターンや設計パターンの追加と改善
- 品質計測のベンチマークデータの公開。5 節に書いた循環依存、複雑度、テストカバレッジなどの定量的な指標です
- Hora Kit を利用した数十万行規模のサンプルコードと仕様書の公開
12. まとめ
Hora Kit を作るにあたって弊社が一番強く意識したのは、「AI が要件を決めない」ことと、「動作の担保を人の目からテストに移す」ことの 2 つでした。
前者があるから仕様書を信じられるようになり、後者があるからコードを細かく読まなくてよくなりました。その結果、人が見るのは仕様と設計が中心になり、コードは要所だけ確認して、最後に画面を触って確認すれば本番に出せる、という状態に落ち着いています。弊社にとっては、これが本当の意味での自動開発です。
現状、速さは一部犠牲にしています(人間よりははるかに速いですが)。本番に出すものを AI に作らせるのであれば、そこは払うべきコストだと弊社は考えていますが、この判断はプロジェクトの性質によって変わると思います。
現状の hora-boilerplate は弊社の技術スタックを前提としたものですが、hora-core は一般的な Web 開発に適用できる構成にしており、技術スタックごとの skills を拡張することで、あらゆるフレームワークや言語への対応が可能です。AI に本番のコードを書かせるソリューションに困っている方は、ぜひ試してみてください。使ってみて詰まったところや、こうしてほしいところがあれば、Issue で教えてください。自分たちのスタック向けの skills を一緒に作りたい、という方も歓迎です。
始めるならこちらから。 https://github.com/openreachtech/hora-boilerplate
中身を読むならこちらから。 https://github.com/openreachtech/hora-core
AI にコードを任せる範囲をどこまで広げるか悩んでいるどなたかの参考になれば幸いです。