強化学習した動きを、シミュレーションから実機へ——バク転・倒立・壁越えを四足ロボットに載せるまで
シミュレーションの中では何でもできる。難しいのは、その動きを実機の上で同じように再現することです。私たちは、Isaac Labで学習しMuJoCoで確かめた運動ポリシーを実機に載せ、ギャロップ走行・後足倒立・バク転・ジャンプ・壁越え・起き上がりを実機で成功させてきました。 本記事では、学習→sim-to-sim→実機デプロイのパイプライン、報酬設計の「抜け穴」との戦い、そしてsim-to-realギャップを実測で潰していく過程を紹介します。
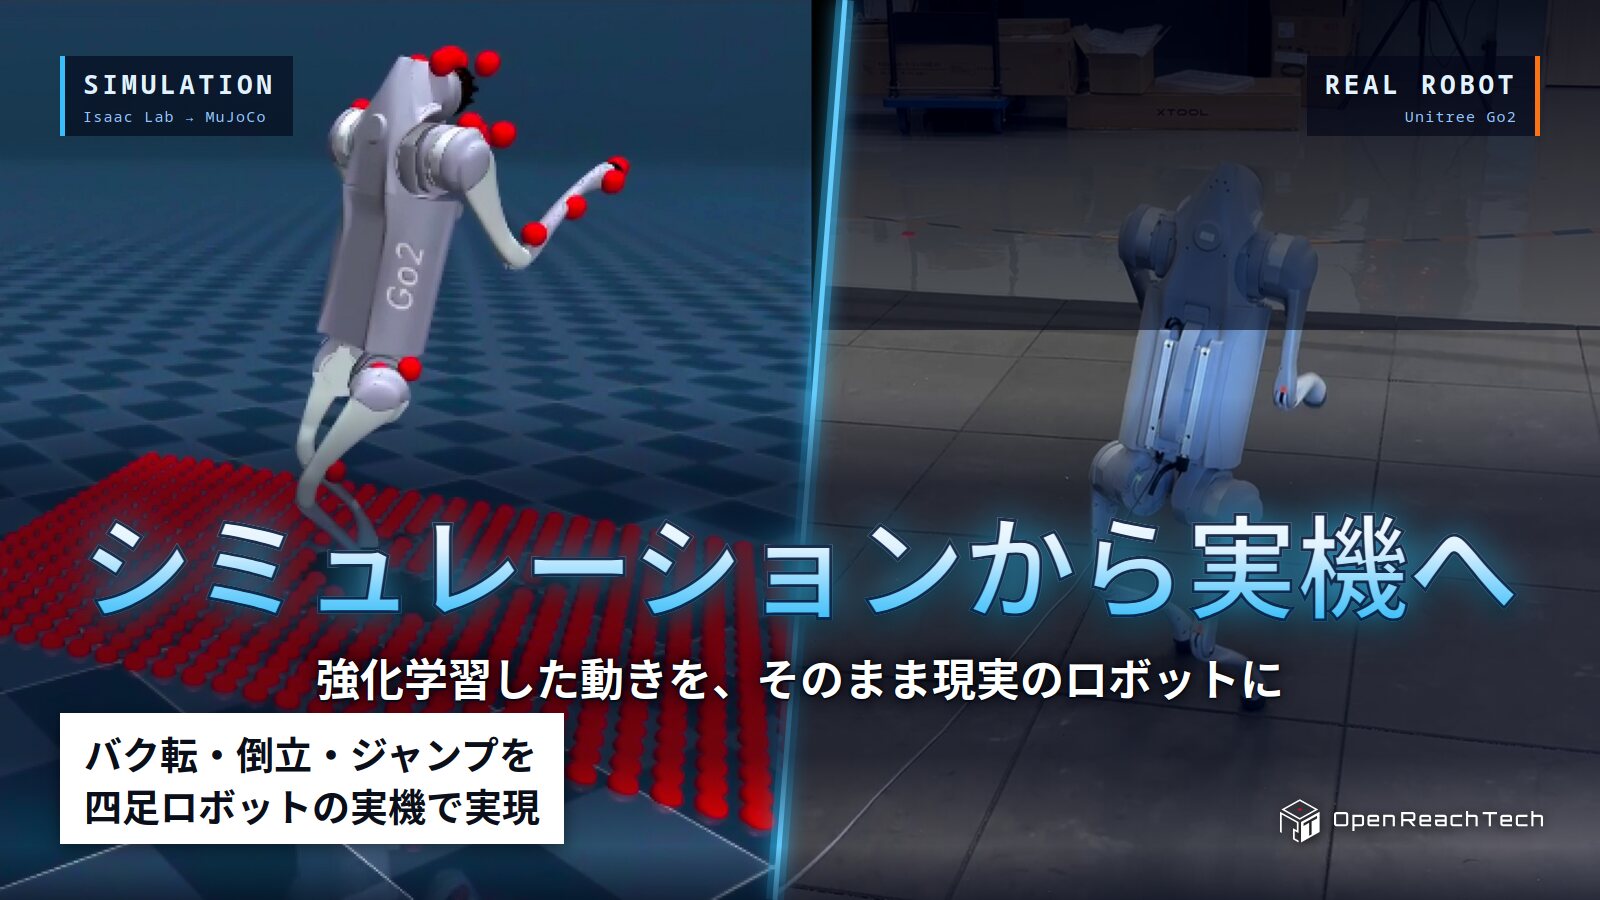
強化学習した動きを、シミュレーションから実機へ
1. シミュレーションでは何でもできる。問題はその先
強化学習でロボットの動きを作る——いまやGPU1枚あれば、数千体のロボットを並列でシミュレーションし、数時間でバク転を覚えさせることもできます。
しかし、シミュレーションで完璧に動いたポリシーを実機に載せると、たいてい最初の一歩で転びます。関節の重さ、モーターが本当に出せるトルク、指令が届くまでの数ミリ秒の遅れ。シミュレーションが「なかったこと」にしている現実の細部が、すべて牙をむきます。
私たちが担当しているのは、まさにこの「シミュレーションの中の動き」を「実機の動き」に変える仕事です。2026年6月からの約5か月で、市販の四足ロボット Unitree Go2 の実機で次の動作を成功させました。
- ギャロップ走行(脚の接地順序を指定した高速走行)
- 後足倒立(後ろ足2本で立ち上がる)
- バク転
- ジャンプ
- 倒立からの壁越え(転倒なしで5回連続、高さ30cmの壁を2/2)
- 起き上がり(仰向け・横倒しからの自力復帰)
さらに人型ロボット Unitree G1 でも、シミュレーションで学習した単一モーション6本のうち5本が実機でシミュレーションどおりに動作(歩行・走行・スクワット歩き・カンフー・回し蹴りなど)しています。
Unitree Go2のポリシーをシミュレーションで学習・検証している様子。左上から:Isaac Simでの並列学習(ジャンプ)、MuJoCoでの後足倒立、Isaac Simでの階段地形の並列学習、MuJoCoでの屈み歩行(赤い点は高さマップの計測点)
Unitree G1の全身モーション模倣ポリシー(MuJoCo)
2. パイプライン:学習 → sim-to-sim → 実機
① 学習 ── Isaac Sim / Isaac Lab
   PPO・数千環境を並列/報酬設計・カリキュラム・ドメインランダム化
      ↓
② sim-to-sim ── MuJoCo+実機と同じC++コントローラで再検証
   「別の物理エンジンでも同じように動くか」
      ↓
③ 実機 ── ONNX化 → ロボット搭載のJetson上で50Hz推論
   段階試験(吊り下げ → 平地 → 本番動作)
学習基盤は Isaac Sim 5.1 / Isaac Lab 2.3 / rsl-rl。社内のオンプレGPUサーバー(合計5台)で回しています。規模感の一例として、4,096並列環境×3,000イテレーションの学習が2.5〜3.5時間、人型の全身モーション模倣40本の学習がGPU1枚で約2時間です。
実機側では、学習したポリシーをONNXに変換し、ロボットに搭載したJetson上のC++コントローラで動かします。ポリシーの推論は1回あたり約0.4ms、制御周期は50Hz。学習用の環境と実機用のコントローラで入出力の定義を完全に一致させることが、地味ですが最も重要なポイントです(後述しますが、ここが1か所ずれるだけでロボットは全転倒します)。
3. 報酬設計:ロボットは「ずる」をする
強化学習のロボットは、報酬を最大化するためなら手段を選びません。開発中に遭遇した「抜け穴」をいくつか紹介します。
階段を後ろ向きに登る。 階段登坂の報酬が体の向きを区別していなかったため、ロボットは体を反転させ、後ろ足から登る方が得だと学習しました。確かに登れてはいる。でも、使い物にはなりません。
「動かない」が最適解になる。 胴体の高さを保つ報酬を加えたところ、指標上は最も良い成績のポリシーが生まれました。実機に載せてみると——ほとんど動かない。静止していれば高さは完璧に保てるからです。
足を上げる報酬が、常にゼロだった。 階段用に標準の「足の持ち上げ」報酬を使ったところ、座標系の扱いの関係で値が常にゼロになっていることが判明。自前の報酬項を新設しました。
こうした経験から、私たちは指標だけを見て判断しないことを徹底しています。学習のたびに動画を確認し、報酬の自動調整を行うAIエージェントにも「指標を改変して見かけの好結果を出すことを禁止」と明記しています。
一方で、うまくいった工夫もあります。
- ギャロップ:各足の接地タイミング(位相)を明示的に指令し、その追従度を報酬にする
- ジャンプ:トルクのログを見ると、膝のモーターが能力の7割弱しか使われていなかった。膝を使わせる方向に報酬を調整し、跳躍高さが 40cm → 65cm(シミュレーション)に
- 走り幅跳び:お手本の軌道を一切与えず、物理式から計算した「飛距離」そのものを目的関数に
4. カリキュラム:補助輪をつけて、外していく
バク転や側転のような動作は、いきなり学習させても成功体験がないため、ロボットは「何もしない」に落ち着きがちです。そこで、人間の体操教室と同じ発想を取り入れました。
- 外力による補助:ギャロップ学習では、最初は胴体を前方へ最大150Nで「引っ張って」あげる。成功率が60%を超えるたびに少しずつ補助を弱め、最後はゼロに。側転2回転やバク転も、まず外力で「経験させてから」自力でできるようにしました。
- 難易度の段階化:平地 → 不整地 → 階段 → 壁 と、ロボットの上達に合わせて地形を自動で難しくする。壁越えは「平地 → 不整地 → 壁」の順に鍛えた方が精度が上がりました。
- 途中から始める:壁越えでは、エピソードの3割を「壁を登っている途中の姿勢」からスタートさせ、難所の経験を集中的に積ませました。
5. sim-to-realギャップは「実測」で潰す
実機で動かない原因を「なんとなくパラメータを揺らす(ドメインランダム化)」で吸収するのは限界があります。私たちは、ずれの正体を1つずつ実測で特定することにこだわりました。
| 判明したずれ | どう見つけたか | 対処 |
|---|---|---|
| 指令が届くまで 8〜10ms の遅れ | 1kHzで記録した指令と実際の動きの相互相関 | 学習時に0〜30msの遅延をランダムに挿入 |
| 公式設定でモーターの回転子の慣性が抜けており、関節が実機より「軽い」 | MuJoCoでの不安定挙動を追跡 | 正しい値を設定し再学習 |
| 実機の膝の可動域がシミュレーションより広い | 実機で関節角を計測 | 学習側の可動域を実機に合わせる |
さらに、胴体を吊った状態で関節にさまざまな周波数の信号を入れ、その応答から関節の慣性や摩擦を同定する計測も行い、学習に反映しています。
たとえば前足での倒立は、当初実機で失敗していました。原因を調べた結果、わずか8〜10msの指令遅延が決定打だと分かりました。シミュレーションでは数ミリ秒の遅れが存在しないため、繊細なバランス動作ほど影響を受けます。
「Isaacの成績は、MuJoCoでの成功を予測しない」
もうひとつの教訓が、sim-to-sim の重要性です。Isaac Labでは高さ45cmの壁を越えられたポリシーが、MuJoCoでは40cmがやっと、ということが繰り返し起きました。物理エンジンが違えば、接触や摩擦の計算も違います。2つ目の物理エンジンで通らないものは、実機ではまず通らない——これを関門にしています。
同じ歩行ポリシーをIsaac Sim(左)とMuJoCo(右)で実行し、挙動を照合するsim-to-simの例(Unitree G1)
また、学習側とデプロイ側でジャンプ指令の正規化の分母が1.5秒と2.2秒で食い違っており、全試行で転倒したこともありました。こうした「設定のずれ」を防ぐため、ONNXの入力次元やハッシュ値の照合を実機試験の手順に組み込んでいます。
Go2の起き上がりポリシーの改良前(左)と、物理パラメータを実機に合わせて再学習した改良後(右)の比較(MuJoCo)
6. 安全に実機を動かすための仕組み
アクロバット動作の実機試験は、一歩間違えれば機体を壊します。そのため、ソフトウェアと運用の両面で安全策を組み込んでいます。
- 段階試験:吊り下げ → 歩行 → 立ち上がり → 本番動作 → 高さを段階的に上げる。各段階に合格・中止の基準を設定
- 非常停止は2系統:リモコン(ネットワークを経由しない)とキーボード。操作担当と停止担当を分ける
- 自動脱力:一定以上の傾き、規定時間内に着地しない、出力の異常値で自動停止
- 起動時チェック:確認入力がない限り起動しない、想定外の高さの指定は拒否する
あわせて、カメラ映像を見ながらゲームパッドで操作できるAndroidアプリ、GPUサーバー群の監視ツール、学習完了を通知するbotなど、開発を回すための周辺ツールも自分たちで作っています。
7. おわりに
強化学習によるロボット制御は、論文やデモ動画では華やかですが、実機で再現するまでには、遅延・トルク・可動域・制御周期といった「地味なずれ」を1つずつ潰していく泥臭い工程があります。Open Reach Techは、その工程をソフトウェア開発会社としての品質管理の考え方——設定の一元化、テストの関門化、手順の標準化——で回しています。
- Isaac Lab / MuJoCo による運動ポリシーの学習・検証基盤の構築
- sim-to-realギャップの計測と、実機デプロイ(Jetson / ONNX / C++)
- 報酬設計・カリキュラム設計による、新しい動作の開発
自社のロボットに「動き」を載せたい、シミュレーションでは動くのに実機で動かない——そんな課題をお持ちの方は、ぜひご相談ください。
あわせて、デジタルツイン上でロボットの走破性を検証した事例「造船所のデジタルツインで、ロボットの歩行を検証する」もご覧ください。